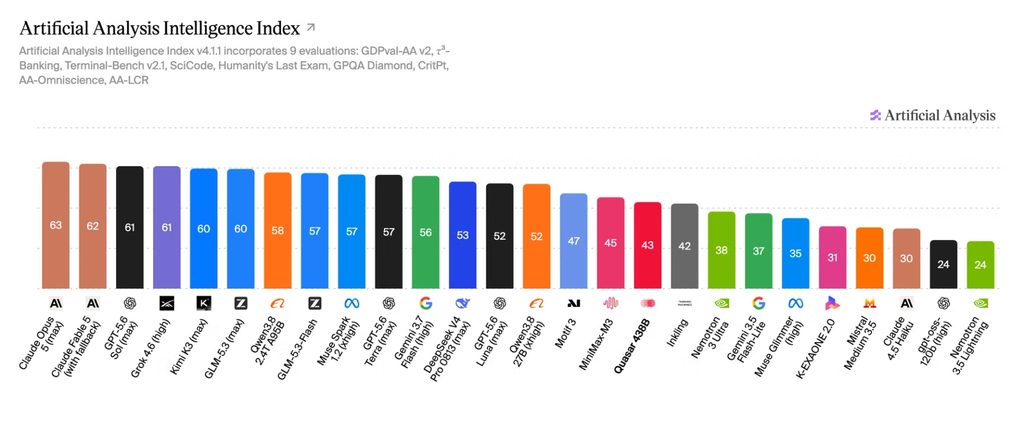
La compañía Multiverse Computing ha lanzado Quasar 438B, su primer gran modelo de lenguaje y el primero orientado a razonamiento empresarial a gran escala. El sistema funciona en inglés y español, y alcanza una puntuación de 43 en el Artificial Analysis Intelligence Index, la cifra más alta registrada por un modelo europeo en este índice. Se trata de un salto significativo para una empresa que hasta ahora se había especializado en técnicas de compresión y eficiencia de modelos, y que con Quasar da el paso hacia la clase de modelos de más de 400.000 millones de parámetros.
Con sus 43 puntos, Quasar 438B se sitúa por delante de Mistral Medium 3.5 (30 puntos), NVIDIA Nemotron 3 Ultra (38 puntos) e Inkling (42 puntos). El liderazgo global del ranking sigue en manos de Claude Opus 5, con 63 puntos, lo que deja claro que la distancia con la frontera absoluta del sector todavía es amplia, aunque Quasar se consolida como la referencia europea del segmento.
Velocidad de respuesta a la altura de los modelos punteros
Más allá de la puntuación, Quasar destaca por su rapidez. Genera una respuesta de 500 tokens, incluyendo el tiempo de razonamiento, en 15,3 segundos. Solo tres modelos de la comparativa son más veloces, y de ellos únicamente Gemini 3.7 Flash logra además superarle en el índice de inteligencia. El resto de sistemas que puntúan por encima de Quasar necesitan bastante más tiempo para responder: solo dos lo hacen en menos de 25 segundos, mientras que los demás tardan entre 38 y 156 segundos. Frente a Mistral Medium 3.5, la comparación es doblemente favorable para Quasar, que puntúa más alto (43 frente a 30) y responde más rápido (15,3 frente a 18,8 segundos).
Razonamiento sobre contextos largos
En la prueba AA-LCR, que mide la capacidad de extraer y conectar información repartida en documentos extensos, Quasar obtiene 75,0 puntos, un resultado prácticamente igualado con Grok 4.6 (high) y a menos de un punto de Claude Opus 5 (75,7) y de Qwen3.8 2.4T A95B (75,3). Esta es la evaluación en la que el modelo europeo se acerca más al grupo de cabeza, superando a Nemotron 3 Ultra por 4 puntos y a Mistral Medium 3.5 por 9,7. Es precisamente en este tipo de tareas (análisis documental, investigación corporativa y flujos de trabajo con agentes) donde Multiverse Computing sitúa el valor diferencial de su modelo.
Terminal-Bench, el margen de mejora más evidente
En Terminal-Bench v2.1, la prueba que evalúa a los agentes trabajando en entornos de terminal reales, Quasar logra 69,3 puntos, por delante de Mistral Medium 3.5 (18,7 puntos menos) y de Nemotron 3 Ultra (15,4 puntos menos), aunque todavía a distancia del grupo de cabeza, liderado por Claude Opus 5 con 89,1 puntos. Desde Multiverse Computing reconocen que este es el área con más margen de mejora y hacia donde se orientará el siguiente ciclo de desarrollo del modelo.
Un modelo para agentes empresariales y desarrollo de software
Quasar 438B está diseñado para organizaciones que despliegan agentes de desarrollo de software, copilotos técnicos, sistemas de investigación y automatización de flujos de trabajo. Sus resultados en Terminal-Bench y en contexto largo respaldan el uso de agentes que necesitan mantener contexto, coordinar acciones y resolver tareas de varios pasos, mientras que su velocidad de respuesta permite integrarlo en productos interactivos sin la latencia habitual de esta clase de modelos. El soporte nativo de inglés y español lo convierte además en una base práctica para empresas europeas e internacionales que buscan capacidades de razonamiento sin limitar su despliegue a un solo idioma.
El modelo ya está disponible a través de la API de CompactifAI, lo que permite a los equipos técnicos probarlo sin necesidad de desplegar infraestructura propia, en línea con la estrategia de Multiverse Computing de hacer más accesible y eficiente el acceso a modelos de gran escala.